Ein Modell ist eine Stichprobe.
Eine einzelne LLM-Antwort ist eine Ziehung aus einer Verteilung. Mit Kirat legt Claude dieselbe Frage ChatGPT und Gemini vor. Jede Modellfamilie bezieht unabhängig Position, Claude reicht seine eigene ein, und das Ergebnis hält jede Stimme mit ihrer selbst angegebenen Konfidenz fest. Die Gegenstimme bleibt erhalten, statt weggemittelt zu werden. Die Debatte endet nach höchstens zwei Runden, und diese Grenze wird im Code durchgesetzt, nicht in einem Prompt.
Fünf aufgezeichnete Läufe, einer pro Tool.
Echte Aufzeichnungen von Kirats Tools, entstanden am 13. Oktober 2026 mit der Version, die Sie kaufen, mit Fragen und Aufgaben wie Ihren. Wählen Sie ein Tool und sehen Sie dem Rat bei der Arbeit zu. Dies ist eine Aufzeichnung: Nichts, was Sie hier anklicken, ruft ein Modell auf, und nichts verlässt diese Seite. Der Chat ist zur Veranschaulichung formuliert und gibt nur das aufgezeichnete Ergebnis wieder; was Claude an Kirat geschickt hat und was zurückkam, steht unverändert unter „Im Hintergrund“.
Tool auswählen
Lass Kirat darüber abstimmen: Kann in unserem systematischen Review ein einzelner LLM-Screening-Durchgang den zweiten menschlichen Screener ersetzen?
kirat_voteRat befragt
Der Rat hat entschieden (einstimmig 3:0): Das LLM als zusätzlichen Screener einsetzen; Menschen lösen Konflikte.
Alle drei Positionen, meine eingeschlossen, zeigen in dieselbe Richtung. Jede kommt mit Begründung.
Im Hintergrund
kirat_voteWas Claude an Kirat schickt
Frage: Kann in unserem systematischen Review ein einzelner LLM-Screening-Durchgang den zweiten menschlichen Screener ersetzen?
Gesendeter Kontext: Titel-und-Abstract-Screening von etwa 3.000 Datensätzen für einen systematischen Review in der Versorgungsforschung, der veröffentlicht werden soll. Aktuelles Protokoll: zwei unabhängige menschliche Screener, Konflikte werden durch Diskussion gelöst. Die Personalzeit ist knapp. Der Review folgt PRISMA, und die Gutachter der Zeitschrift werden fragen, wie gescreent wurde. Eine relevante Studie zu übersehen (falscher Ausschluss) ist schlimmer, als eine irrelevante einzuschließen.
Optionen: Ja, den zweiten menschlichen Screener ersetzen · Das LLM als zusätzlichen Screener einsetzen; Menschen lösen Konflikte · Nein, bei zwei menschlichen Screenern bleiben, ohne LLM
Ergebnis des Rats
Aufgezeichnet am 13. Oktober 2026 mit kirat_vote auf der Standard-Aufwandsstufe; jede Sitzung dauerte unter 20 Sekunden und kostete unter zwei Cent. Fragen, Optionen und Kontext wurden auf Englisch gesendet und sind hier übersetzt, die Begründungen vollständig wiedergegeben. ChatGPT und Gemini antworteten teilweise auf Deutsch (Gemini viermal, ChatGPT einmal); diese Antworten stehen hier im Original, die übrigen sind aus dem Englischen übersetzt. Bei der Frage nach dem Free Tier unterlag Claude 2:1, und sein Einwand blieb im Protokoll. Die Konfidenzwerte sind jeweils die Selbsteinschätzung des Modells.
Lass Kirat das Auswertungsskript für das Screening unseres systematischen Reviews auf Korrektheit prüfen.
kirat_reviewRat befragt
Kirat hat 11 bestätigte Befunde gefunden (6 × hoch, 4 × mittel, 1 × niedrig). Jeder Befund wurde von der jeweils anderen Modellfamilie gegengeprüft.
Fang mit denen oben in der Liste an; zu jedem gibt es einen Vorschlag zur Behebung.
Im Hintergrund
kirat_reviewWas Claude an Kirat schickt
Schwerpunkt: Korrektheit einer Screening-Auswertung für ein systematisches Review
Gesendeter Code:
# screening/agreement.py — compares two screeners' include/exclude decisions (Python 3.12, pandas)
import pandas as pd

a = pd.read_csv('screener_a.csv')   # columns: record_id, decision ('include'/'exclude')
b = pd.read_csv('screener_b.csv')

merged = a.merge(b, on='record_id', suffixes=('_a', '_b'))

agree = (merged.decision_a == merged.decision_b).mean()
p_inc_a = (merged.decision_a == 'include').mean()
p_inc_b = (merged.decision_b == 'include').mean()
expected = p_inc_a * p_inc_b + (1 - p_inc_a) * (1 - p_inc_b)
kappa = (agree - expected) / (1 - expected)

conflicts = merged[merged.decision_a != merged.decision_b]
excluded = merged[merged.decision_a == 'exclude']

print(f'Records screened: {len(a)}')
print(f"Cohen's kappa: {kappa:.2f}")
excluded.record_id.to_csv('excluded.csv', index=False)
conflicts.to_csv('conflicts.csv', index=False)
Ergebnis des Rats
- hoch
Der standardmäßige Inner Join entfernt alle record_id-Werte, die nur in einer der beiden Dateien vorkommen. Kappa und Konflikte werden dadurch nur für die Schnittmenge berechnet, ohne fehlende Screenings sichtbar zu machen. Gleichzeitig meldet „Records screened“ in Zeile 18 die Länge von a statt der tatsächlich analysierten Schnittmenge.
Behebung: Einen Outer Join mit merge-Indikator verwenden, die ID-Mengen explizit vergleichen und fehlende Entscheidungen separat melden bzw. als Datenfehler behandeln. Für jede Kennzahl den tatsächlich verwendeten Nenner ausgeben.
- hoch
Die Eindeutigkeit von record_id wird nicht geprüft. Doppelte IDs führen beim Merge zu einem Many-to-many-kartesischen Produkt und gewichten einzelne Studien mehrfach, wodurch Übereinstimmung, Prävalenzen, Kappa und Ausgabedateien verfälscht werden.
Behebung: Vor dem Merge in beiden Dateien record_id auf Nicht-Nullheit und Eindeutigkeit prüfen und bei Duplikaten abbrechen. Zusätzlich merge(..., validate='one_to_one') verwenden.
- hoch
Entscheidungswerte werden nicht validiert. Fehlwerte, Tippfehler, Groß-/Kleinschreibung oder weitere Kategorien werden bei der Berechnung der Include-Prävalenz implizit wie „exclude“ behandelt, während die beobachtete Übereinstimmung exakte Werte vergleicht. Damit entspricht die Berechnung nicht mehr einem binären Cohen-Kappa und kann widersprüchliche Resultate liefern.
Behebung: decision vor der Analyse kontrolliert normalisieren und sicherstellen, dass jeder Wert genau 'include' oder 'exclude' ist. Fehlende oder unbekannte Werte als Datenfehler bzw. unvollständiges Screening separat behandeln.
- hoch
excluded enthält alle von Screener A ausgeschlossenen Datensätze, einschließlich Konflikten, bei denen Screener B „include“ entschieden hat. Solche Datensätze werden somit gleichzeitig nach excluded.csv und conflicts.csv geschrieben. Falls excluded.csv die endgültig ausgeschlossenen Treffer darstellen soll, können ungeklärte Konflikte fälschlich aus dem Review entfernt werden.
Behebung: Ohne dokumentierte Vorrangregel nur übereinstimmende Ausschlüsse auswählen, also (decision_a == 'exclude') & (decision_b == 'exclude'). Konflikte bis zur Konsensentscheidung ausschließlich in conflicts.csv halten.
- hoch
Fälschliche Filterung der ausgeschlossenen Studien: 'excluded' berücksichtigt ausschließlich die Entscheidung von Screener A ('merged.decision_a == "exclude"'). Liegt ein Konflikt vor (Screener A schließt aus, Screener B schließt ein), wird die Studie fälschlicherweise als ausgeschlossen gewertet.
Behebung: Ausschlüsse nur dann exportieren, wenn beide Screener übereinstimmend 'exclude' gewählt haben (z. B. '(merged.decision_a == "exclude") & (merged.decision_b == "exclude")'), oder die Konfliktklärung abwarten.
- hoch
excluded.csv enthält jeden Datensatz, den Screener A ausgeschlossen hat, einschließlich der Konflikte, in denen Screener B ihn eingeschlossen hat. Diese Datensätze fallen vor der Konfliktbesprechung heraus, und genau das ist der falsche Ausschluss, den das Protokoll vermeiden muss.
Behebung: Nur Datensätze ausschließen, die beide Screener ausgeschlossen haben: merged[(merged.decision_a == 'exclude') & (merged.decision_b == 'exclude')]; jeden Konflikt zuerst in die Klärung geben.
- mittel
Wenn beide Screener ausschließlich dieselbe Kategorie verwenden, ist expected gleich 1 und der Nenner von Kappa gleich 0. Das Ergebnis wird NaN bzw. kann eine Division-durch-null-Warnung erzeugen; die formatierte Ausgabe „nan“ erklärt nicht, dass Kappa mathematisch nicht definiert ist. Auch eine leere analysierte Schnittmenge führt zu nicht aussagekräftigen NaN-Kennzahlen.
Behebung: Vor der Division prüfen, ob überhaupt gepaarte gültige Entscheidungen vorliegen und ob 1 - expected größer als 0 ist. In degenerierten Fällen Kappa explizit als „nicht definiert“ ausweisen und die zugrunde liegenden Häufigkeiten berichten.
- mittel
Mögliche Division durch Null bei Cohen's Kappa, wenn der erwartete Zufallswert 'expected' gleich 1 ist (z. B. wenn beide Screener für 100% der Datensätze dieselbe Kategorie wählen).
Behebung: Vor der Berechnung abfangen, ob '1 - expected == 0' ist, und in diesem Fall einen definierten Wert (z. B. 1.0 oder NaN) zuweisen.
- mittel
Stummes Verwerfen von Datensätzen durch den Standard-Inner-Join. Wenn Screener A und Screener B unterschiedliche Mengen an 'record_id's bewertet haben, werden Unstimmigkeiten bei den bearbeiteten Studien nicht gemeldet. Zudem entspricht 'len(a)' in der Konsolenausgabe dann nicht der Anzahl tatsächlich gematchter Studien.
Behebung: Prüfen, ob 'len(a) == len(b) == len(merged)' gilt, oder einen Outer Join durchführen, um unvollständig bewertete Datensätze explizit anzuzeigen.
- mittel
Der Inner Merge verwirft stillschweigend Datensätze, über die nur ein Screener entschieden hat, und die ausgegebene Anzahl verwendet len(a). Nicht gescreente Datensätze verschwinden sowohl aus der Übereinstimmung als auch aus den PRISMA-Zahlen.
Behebung: Mit how='outer', indicator=True mergen und abbrechen oder eine Meldung ausgeben, wenn einem Datensatz die Entscheidung eines der beiden Screener fehlt.
- niedrig
Fehlende Eingabebereinigung und Behandlung von Fehlwerten in der Spalte 'decision'. Groß-/Kleinschreibung, Whitespaces oder NaN-Werte führen zu fehlerhaften Vergleichen.
Behebung: Spaltenwerte vor dem Vergleich bereinigen (z. B. mit '.str.strip().str.lower()') und Datentypsicherheit sicherstellen.
Gezeigt: jeder bestätigte Befund mit seiner Behebung, so wie die Mitglieder ihn geschrieben haben; die Begründung der Prüfer ist auf ihr Urteil gekürzt. Duplikate werden nicht zusammengeführt, ein Problem kann also mehrfach erscheinen, wenn mehrere Mitglieder es melden. Was die Mitglieder auf Deutsch geschrieben haben, steht hier im Original; was auf Englisch gesendet oder geschrieben wurde, ist hier übersetzt, Code-Kommentare ausgenommen.
Sammle mit Kirat Ideen, wie wir beim Screening von rund 3.000 Datensätzen Zeit sparen, ohne den Review zu schwächen.
kirat_brainstormRat befragt
Der Rat hat 14 Ideen gesammelt und jede anonym bewertet. Die drei stärksten:
- Ausschluss-Schranke mit zwei Menschen (18/20 Punkte)
- Kalibrierungssprint mit einem Grenzfall-Register (16/20 Punkte)
- Schnelle binäre Konsole statt Mini-Datenextraktion (15/20 Punkte)
Im Hintergrund
kirat_brainstormWas Claude an Kirat schickt
Thema: Ideen, wie sich der Personalaufwand für das Titel-und-Abstract-Screening von etwa 3.000 Datensätzen senken lässt, ohne die Strenge eines systematischen Reviews zu schwächen
Gesendeter Kontext: Systematisches Review in der Versorgungsforschung, zur Veröffentlichung geplant. Aktuelles Protokoll: zwei unabhängige menschliche Screener, Konflikte werden durch Diskussion gelöst. Personalzeit ist knapp. Die Gutachtenden der Zeitschrift werden fragen, wie das Screening durchgeführt wurde. Eine relevante Studie zu übersehen (falscher Ausschluss) ist schlimmer, als eine irrelevante einzuschließen. HARTE VORGABE: Die Methode muss nach PRISMA 2020 berichtbar sein. HARTE VORGABE: Die Rate falscher Ausschlüsse darf nicht steigen.
Ergebnis des Rats
- 1
Ausschluss-Schranke mit zwei Menschen
Reviewer A screent jeden Datensatz, doch die Einschlüsse und unsicheren Entscheidungen von A gehen direkt weiter; Reviewer B bewertet unabhängig nur die von A vorgeschlagenen Ausschlüsse. Ein Datensatz wird nur ausgeschlossen, wenn beide Menschen ihn unabhängig ausschließen, und jede Uneinigkeit wird automatisch weitergereicht, wodurch die meisten Konfliktbesprechungen entfallen. Das bricht bewusst die weiche Annahme des aktuellen Protokolls, dass zwei Menschen jeden Datensatz bewerten müssen; es lohnt sich, weil es Screening-Zeit spart und dabei strukturell zwar mehr falsche Einschlüsse zulässt, aber keine zusätzlichen falschen Ausschlüsse, und es lässt sich im PRISMA-Abschnitt zum Auswahlprozess einfach beschreiben.
- 2
Kalibrierungssprint mit einem Grenzfall-Register
Eine geschichtete erste Charge unabhängig doppelt screenen, Konflikte klären und wiederkehrende Unklarheiten in kurze operative Regeln mit Positiv- und Negativbeispielen überführen. Die Regeln festschreiben, bevor es weitergeht; die Pilotentscheidungen nur behalten, wenn sich die Eignungskriterien nicht geändert haben, andernfalls neu screenen. Das erhält das doppelte unabhängige Screening und senkt zugleich den späteren Aufwand für Beratung und Konfliktklärung, und die Kalibrierung lässt sich nach PRISMA berichten.
- 3
Schnelle binäre Konsole statt Mini-Datenextraktion
Beiden Prüfenden eine verblindete, per Tastatur bedienbare Oberfläche geben, die auf Einschluss, Ausschluss oder unsicher beschränkt ist, mit stets vollständig sichtbarem Titel und Abstract; detaillierte Kodierung und Ausschlussgründe auf die Volltextprüfung verschieben. PRISMA 2020 verlangt auf der Titel-und-Abstract-Stufe keine Gründe pro Datensatz. Der Entscheidungsprozess bleibt unverändert, doch vermeidbarer Aufwand für Lesen, Klicken und Dokumentation fällt weg.
- 4
Maschinelles Ventil nur für Einschlüsse
Als Mutation der Ausschluss-Schranke mit zwei Menschen in einem Schritt die von A vorgeschlagenen Ausschlüsse durch einen validierten Klassifikator laufen lassen, der Datensätze nur zum Einschluss freigeben darf, niemals ausschließen; Reviewer B screent unabhängig alles, was der Klassifikator nicht freigibt. Der endgültige Ausschluss erfordert weiterhin übereinstimmende Entscheidungen von zwei Menschen, sodass ein Fehler der Maschine zwar Volltexte hinzufügen, aber keinen falschen Ausschluss erzeugen kann. Modell, Version, Eingaben, Schwellenwerte, Validierung und seine strikt auf Einschlüsse beschränkte Rolle nach PRISMA berichten.
- 5
Asymmetrisches Exklusions-Screening
Ein Erstprüfer klassifiziert alle 3.000 Datensätze vollständig. Der Zweitprüfer prüft exklusiv nur diejenigen Datensätze, die vom Erstprüfer ausgeschlossen wurden, um falsch-negative Treffer abzufangen (Einschlüsse werden direkt akzeptiert). Dies halbiert den Aufwand des Zweitprüfers nahezu, hält das Risiko falscher Exklusionen extrem niedrig und erfüllt alle PRISMA-Vorgaben.
- 6
Screening für ertragreiche Teilmengen umgehen
Ertragreiche Teilmengen vorab festlegen — etwa Datensätze aus einem hochspezifischen Suchblock, direkte Nachfahren bekannter geeigneter Studien oder Datensätze, die bereits in einem eng verwandten Review eingeschlossen sind — und sie alle ohne Titel-und-Abstract-Entscheidung direkt in die Volltextbeschaffung geben. Das bricht für diese Datensätze bewusst das weiche Zwei-Screener-Protokoll, kann aber die falschen Ausschlüsse nicht erhöhen, weil in der Teilmenge nichts ausgeschlossen wird; der Preis ist zusätzliche Volltextarbeit. Die Umgehungsregel und die daraus resultierenden Zahlen ausdrücklich im PRISMA-Flussdiagramm und in den Methoden zur Auswahl berichten.
- 7
Priorisiertes Screening via Active Learning
Beide Human-Screener nutzen ein Active-Learning-Tool (wie ASReview), das relevante Titel/Abstracts an den Anfang sortiert. Sobald ein statistisch validiertes Abbruchkriterium erreicht ist (z. B. 500 irrelevante Treffer in Folge), wird das Screening beendet. Das Verfahren spart bis zu 70% Zeit, ist PRISMA-2020-konform dokumentierbar und wahrt durch die Algorithmus-Kalibrierung eine minimale Falsch-Exklusionsrate.
- 8
Nur exakte Deduplizierung vor dem Screening
Nur Datensätze entfernen, deren Identität über DOI, Zugangsnummer der Datenbank oder exakten normalisierten bibliografischen Abgleich nachgewiesen ist; die Kopie mit den meisten Metadaten behalten und unsichere Beinahe-Duplikate lediglich markieren. Beide Prüfenden screenen dann jeden verbleibenden eindeutigen Datensatz unabhängig, und PRISMA weist die vor dem Screening entfernten Duplikate aus. Das senkt die Menge, ohne einen Weg zu schaffen, auf dem eine eindeutige Studie ausgeschlossen werden könnte.
- 9
Mensch-KI-Kaskade mit KI-Sicherheitsnetz
Eine Mutation des asymmetrischen Exklusions-Screenings: Ein menschlicher Screener bearbeitet alle Datensätze alleine, während ein auf maximale Sensitivität getrimmtes KI-Modell exklusiv die menschlichen Exklusionen prüft. Nur bei Diskrepanzen prüft ein zweiter Mensch nach. Dies reduziert die Humankapazitäten um über 50% bei vollständiger Abdeckung.
- 10
Vollautomatischer KI-Zweitprüfer
Bricht die weiche Vorgabe, dass zwingend zwei menschliche Personen screenen müssen. Ein Large Language Model (LLM) übernimmt die Rolle des unabhängigen Zweitprüfers mit Zero-False-Negative-Prompting. Es lohnt sich, weil die menschliche Arbeitszeit halbiert wird und LLMs bei Abstract-Screenings nachweislich hohe Recall-Raten erreichen; PRISMA 2020 erlaubt die Angabe von KI-Tools explizit.
- 11
Risikoadaptiertes Single-Screening mit Konfidenz-Triagierung
Bricht die weiche Vorgabe des durchgängigen Doppel-Screenings für den gesamten Datensatz. Wenn der Erstprüfer eine hohe Subjekt-Konfidenz angibt und eindeutige Ausschlussgründe vorliegen, entfällt der Zweitprüfer; nur unsichere Fälle wandern ins Doppel-Screening. Dies spart bis zu 60% Personalzeit, während das Risiko verpasster Studien durch Fokussierung der Ressourcen auf Grauzonen minimal bleibt.
- 12
Zuerst eine Kalibrierungsrunde
Beide Screener screenen dieselben 100 Datensätze, besprechen jeden Konflikt und schärfen die Eignungskriterien vor der Hauptrunde, sodass spätere Konflikte und erneutes Lesen abnehmen.
- 13
Binarisiertes Blitz-Screening mit KI-Triage
Mutation der Active-Learning-Priorisierung: Das Team nutzt eine vereinfachte Oberfläche zur Schnell-Bewertung (nur Klicks für 'Einschluss/Unsicher' vs. 'Ausschluss'). Ein KI-Modell wertet im Hintergrund Unsicherheiten aus und schickt nur Wackelkandidaten in die vertiefte Doppelprüfung. Minimiert kognitive Last und Lesezeit pro Abstract drastisch.
- 14
Deterministisches Pre-Filtering via Match-Algorithmen
Konservative Such-Filter und Skripte sortieren vorab eindeutig unpassende Treffer aus (z. B. falsches Studiendesign oder nicht-menschliche Population). Beide Screener prüfen diese automatisierten Exklusionen nur über eine repräsentative Stichprobe (z. B. 10%). Dies reduziert das manuell zu screenende Gesamtvolumen PRISMA-konform und ohne Sensitivitätsverlust.
Alle Ideen, vollständig und in der Rangfolge. Claudes eigene Idee nimmt anonym und gleichberechtigt teil. Was die Mitglieder auf Deutsch geschrieben haben, steht hier im Original; was auf Englisch gesendet oder geschrieben wurde, ist hier übersetzt.
Lass Kirat einen Titel für unser Methodenpaper über ein LLM als zusätzlichen Screener finden. Genau, ohne Hype.
kirat_createRat befragt
Die Siegervariante (18/20 Punkte): "Large Language Model–Assisted Study Selection in Health Services Research: A Method for Additional Screening in Systematic Reviews"
Mein eigener Entwurf landete auf Platz 2; die Mitglieder haben alle drei anonym bewertet.
Im Hintergrund
kirat_createWas Claude an Kirat schickt
Briefing: Titel für ein Methodenpaper über den Einsatz eines LLM als zusätzlicher Screener in einem systematischen Review in der Versorgungsforschung. Zielgruppe: Forschende und Gutachtende von Fachzeitschriften. Ziel: präzise und zitierfähig, kein Hype. Format: ein Titel, optional mit Untertitel nach einem Doppelpunkt, auf Englisch.
Kriterien: max. 20 Wörter · nennt die Methode und das Setting · keine Aussagen, die über die Daten hinausgehen · keine Hype-Wörter wie „revolutionize“
Ergebnis des Rats
- 1
"Large Language Model–Assisted Study Selection in Health Services Research: A Method for Additional Screening in Systematic Reviews"
Der Titel benennt die Screening-Methode, den Kontext des systematischen Reviews und das Setting der Versorgungsforschung, ohne Leistung oder Nutzen zu unterstellen.
- 2
"An LLM as additional screener: a prospective comparison in a health services systematic review"
Der eigene Entwurf des Orchestrators.
- 3
"Large Language Models as Auxiliary Screeners in Health Services Research Systematic Reviews: A Methodological Evaluation"
Der Titel benennt Einsatzgebiet und Methodik präzise, verzichtet auf Reizwörter und wählt einen sachlichen, zitierfähigen Ton für ein wissenschaftliches Publikationsumfeld.
Headlines und Titel stehen so da, wie sie geschrieben wurden, auf Englisch, wie es die Briefings verlangten. Die Begründung in Claudes Eintrag ist Kirats eigene Kennzeichnung dafür. Was die Mitglieder auf Deutsch geschrieben haben, steht hier im Original; alles andere, was auf Englisch gesendet oder geschrieben wurde, ist hier übersetzt.
Lass Kirat ein Titelbild für meinen Konferenzvortrag über KI-gestütztes Screening erstellen. Seriös, keine Roboter.
kirat_imageRat befragt
Die Jury hat das Bild von gpt-image-2 gewählt (18/20 Punkte). Beide Mitglieder haben beide Bilder anonym bewertet.
Im Hintergrund
kirat_imageWas Claude an Kirat schickt
Briefing: Titelbild für einen Konferenzvortrag über KI-gestütztes Screening in systematischen Reviews: ein ordentlicher Stapel ausgedruckter Forschungs-Abstracts auf einem Schreibtisch, einige in zwei Ablagekörbe sortiert, weiches Tageslicht, dokumentarischer Fotostil. Kein lesbarer Text, keine Logos, keine Gesichter von Menschen.
Kriterien: seriös und wissenschaftlich, kein Hype · keine Roboter oder leuchtenden Gehirne · die Idee des Sortierens ist sichtbar · kein lesbarer Text und keine Logos
Ergebnis des Rats
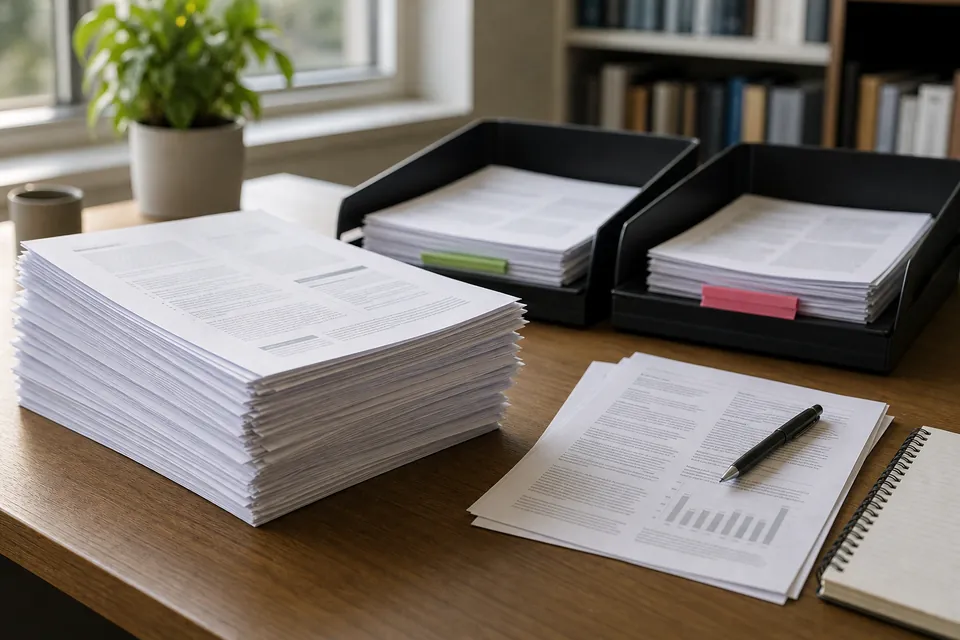
gpt-5.6 · 9/10 Seriöse, dokumentarische Schreibtischszene mit weichem Tageslicht; zwei Ablagen und farbige Reiter vermitteln die Sortierung klar. Keine Logos oder eindeutig lesbaren Texte, keine Personen.
gemini-3.6-flash · 9/10 Sehr gut umgesetzt. Hohe fotografische Qualität im Dokumentarstil, das Sortierkonzept mit Stapeln und Ablagen ist klar verständlich, ohne lesbaren Text oder Gesichter.
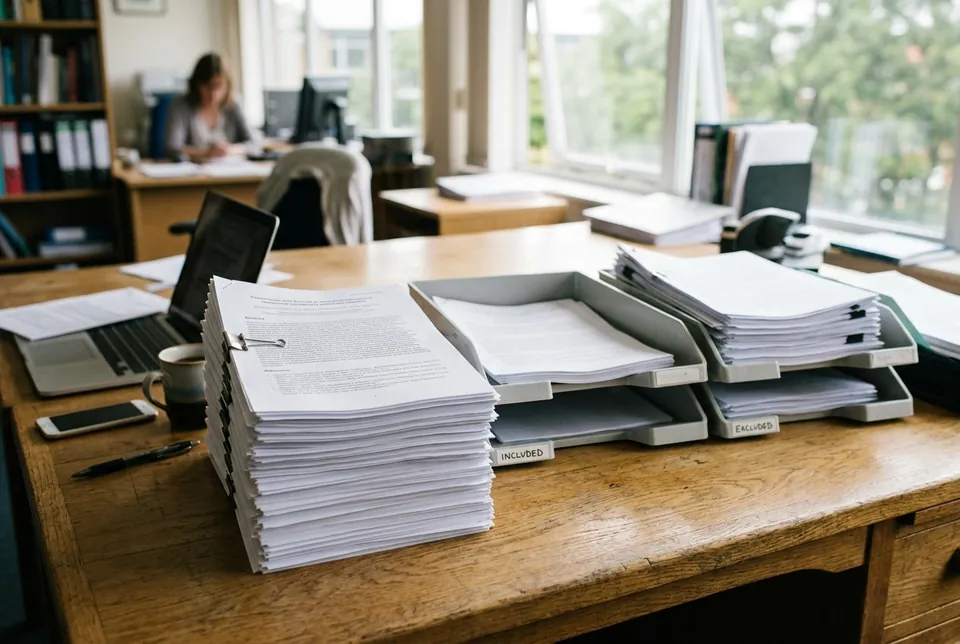
gpt-5.6 · 5/10 Wissenschaftlicher Arbeitskontext und Sortierung sind deutlich erkennbar. Die lesbaren Ablageetiketten verletzen jedoch die Vorgabe „kein lesbarer Text“; zudem ist im Hintergrund eine Person mit erkennbarem, wenn auch unscharfem Gesicht zu sehen.
gemini-3.6-flash · 4/10 Das Motiv passt prinzipiell, jedoch ist im Hintergrund eine Person/ein Gesicht sichtbar und die Ablagen enthalten fehlerhaften, teils lesbaren Text (INCLVDED/EACLVDED).
KI-generierte Bilder, verkleinert und ansonsten unbearbeitet. Mit ≈ markierte Kosten stammen aus parallel gelaufenen Durchläufen: die eigenen Bildkosten jedes Durchlaufs plus ein gleicher Anteil an den Bewertungsaufrufen. Die Rangfolge ist eine Vorauswahl, die endgültige Wahl bleibt bei Ihnen. Was die Mitglieder auf Deutsch geschrieben haben, steht hier im Original; was auf Englisch gesendet oder geschrieben wurde, ist hier übersetzt.
Übereinstimmung wird berichtet. Uneinigkeit geht verloren.
Ein Gutachter fragt, ob der Befund auch mit einer anderen Modellfamilie Bestand hat. Die Antwort heißt: alles von Hand neu ausführen.
Übereinstimmung zwischen Modellen wird als Robustheit beschrieben – ohne Protokoll darüber, was widersprach und wie stark.
Prompt, Modellname, Einstellungen und Kosten liegen in einem Chatverlauf, den niemand exportiert. Bis Freitag sind sie weg.
Jeder Lauf liefert ein Ergebnis, das Sie in einem Methodenteil beschreiben können.
Eine Abstimmung des Rats liefert ein strukturiertes Ergebnis: den Ausgang, die Entscheidung, wie sie zustande kam, die Zahl der Runden, die Stimme jedes Mitglieds mit ihrer selbst angegebenen Konfidenz und die Kosten. Eine Zweidrittelmehrheit entscheidet. Fallen Mitglieder aus und sind die übrigen uneins, entscheidet ein festgelegter Domänenverantwortlicher den Gleichstand. Ohne Mehrheit lautet das Ergebnis needs_human, statt Einigkeit zu erzwingen.
Lass Kirat darüber abstimmen: Den gekoppelten Effort-Standard deckeln oder auf Maximum lassen? Optionen: auf high deckeln, entkoppeln, so lassen.
kirat_voteRat befragt
Der Rat hat entschieden (einstimmig, Runde 1 von höchstens 2, $0.021): Auf high deckeln.
Konfidenz, wie die Modelle sie selbst angeben: ChatGPT 94, Gemini 92, meine 72.
ABB. 1 — Ein echter Lauf, einstimmig. Die Zahlen sind Konfidenzwerte, die die Modelle selbst angeben – siehe die Einschränkungen unten. Weitere Werte für den Ausgang: needs_human, domain_decision, limited, budget_exhausted. Der Chat ist zur Veranschaulichung formuliert; Zahlen und Zitate stammen aus dem aufgezeichneten Ergebnis (Zitate übersetzt).
Was Sie festhalten sollten
Manche Teile des Verfahrens sind im Code festgelegt: das Rundenlimit, die Regel für den Gleichstand, der Budgetwächter. Andere wählen Sie selbst, und sie gehören in Ihren Methodenteil: welche Modelle im Rat sitzen, die Aufwandsstufe, das Datum. Modellnamen sind Einstellungen, die Standardwerte unten sind also nur Standardwerte.
ABB. 2 — Eine minimale Checkliste für die Berichterstattung. Die Kirat-Version und Kirats eigene Einstellungen gehören ebenfalls hinein.
Ein Kauf für Claude Desktop und Claude Code.
Kein Abo, keine Nutzerplätze, kein Konto bei uns. Prüfen Sie vor dem Kauf, wo Kirat läuft:
Wo Kirat läuft
Funktioniert in
- Claude-Desktop-Chats unter macOS und Windows
- Claude Code im Terminal, in VS Code oder im Code-Tab von Claude Desktop
- Cloud-Sitzungen von Claude Code, nach einer einmaligen Einrichtung pro Cloud-Umgebung Mit Grenzen: Alle, die die Umgebung nutzen, können Ihre Keys lesen, und das Tagesbudget zählt pro Sitzung.
Funktioniert nicht in
- Chat im Browser (claude.ai) oder in den Claude-Apps für Mobilgeräte
- Cowork-Aufgaben, die in der Cloud laufen
- Manche Firmenumgebungen: Netzwerke, die einen HTTP-Proxy vorschreiben, und Organisationen, die Desktop-Erweiterungen auf eine Freigabeliste beschränken Fragen Sie vorher Ihre IT.
- 01Claude-Desktop-Erweiterung und Claude-Code-Plugin in einem Download
- 02Setup-Skript für Cloud-Sitzungen von Claude Code
- 03Alle neun Tools: Abstimmung, Code-Review, Ideen-Ranking, Textkritik, Bildvergleich und mehr
- 04Kostenkontrolle: ein Tagesbudget (standardmäßig $5), das Aufrufe zurückhält, die es überschreiten könnten. Nach bestem Bemühen, setzen Sie deshalb auch Limits bei den Anbietern
- 05Lizenz für eine Person, auf Ihren eigenen Geräten und in Ihren Cloud-Umgebungen
- 06Kompatibilitätsupdates nach Möglichkeit — kostenlos, aber ohne Garantie
Läuft in Claude Desktop (macOS/Windows) und Claude Code; Cloud-Sitzungen von Claude Code mit einmaliger Einrichtung — nicht der Chat im Browser oder auf Mobilgeräten. Wo es läuft · Cloud-Grenzen
Kirat kaufenEinmalkauf · Zahlung über Lemon Squeezy (Merchant of Record, Verkäufer), Umsatzsteuer wird im Checkout abgewickelt · Erstattungen: siehe AGB
Die API-Nutzung bezahlen Sie direkt an OpenAI und Google, über Ihre Konten — $0.02–$0.15 pro Ratsentscheidung in unseren Messungen.
Kirat ist nichts für Sie, wenn …
- —Sie Claude nur als Chat im Browser oder auf dem Smartphone nutzen. Kirat läuft in Claude Desktop (macOS/Windows) und Claude Code sowie in Cloud-Sitzungen von Claude Code mit einmaliger Einrichtung — nicht in diesen Chats.
- —Sie einen gehosteten Dienst, Telefon-Support oder garantierte Antwortzeiten brauchen.
- —Sie keine API-Konten und keine Abrechnung bei zwei Anbietern wollen.
- —Sie nur eine Handvoll Entscheidungen im Monat treffen und Antworten gern selbst in getrennten Chats vergleichen.
- —Sie eine Antwort wollen, die sicher klingt. Die Aufgabe eines Rats ist es, Ihnen die Uneinigkeit zu zeigen, und manchmal ist die Uneinigkeit die Antwort.
- —Ihre Daten nicht an OpenAI oder Google gehen dürfen. Alles, was Sie Kirat geben, geht an beide, über Ihre Konten und zu deren Bedingungen.
Bevor Sie kaufen.
Kann ich es zitieren?
Sie können das Verfahren beschreiben und zitieren wie jedes andere Werkzeug: Name, Version, Modellnamen, Aufwandsstufe, Datum, Rundenlimit. Abb. 2 oben ist ein Ausgangspunkt. So viel trägt das Ergebnis.
Es gibt kein Validierungspaper, das Sie zitieren könnten, und keine Fachzeitschrift hat aufgrund dieses Werkzeugs etwas angenommen. Behaupten Sie nicht mehr, als das Ergebnis hergibt.
Ist es reproduzierbar?
Das Verfahren ja. Die Ausgaben nicht – das ist eine Eigenschaft der Modelle, nicht von Kirat. Berichten Sie beides.
Berichten Sie auch die Modellnamen und Daten. Anbieter mustern Modelle aus. Wird eines ausgemustert, tragen Sie den neuen Modellnamen und seine zwei Preise in Kirats Einstellungen ein, und ab dann verwenden Ihre Läufe ein anderes Modell.
Kann ich eine weitere Modellfamilie oder ein lokales Modell hinzufügen?
Nein. Der Rat besteht aus ChatGPT (OpenAI) und Gemini (Google), mit Claude als drittem Abstimmenden. Sie wählen, welche OpenAI- und Gemini-Modelle darin sitzen, denn Modellnamen sind Einstellungen. Kirat unterstützt nur OpenAI und Google; es gibt keinen Adapter für andere Anbieter, und der Code ist nicht Open Source.
Wenn Sie andere Anbieter brauchen, sehen Sie sich PAL MCP an: ein kostenloser Open-Source-MCP-Server, der viele Anbieter unterstützt und ein eigenes Konsens-Werkzeug hat. Prüfen Sie den aktuellen Stand. Wenn er abdeckt, was Sie brauchen, nutzen Sie ihn.
Wenn Sie mit einem Coding-Agenten einen eigenen Rats-Server bauen möchten: Der Blueprint auf der Hauptseite besteht nur aus Dokumenten – der Spezifikation, den Architekturentscheidungen mit ihrer Begründung, der Abnahme-Checkliste und den Benchmark-Daten hinter den Zahlen auf dieser Website. Um Kirat zu nutzen, brauchen Sie ihn nicht.
Was ist mit sensiblen oder personenbezogenen Daten?
Alles, was Sie Kirat geben (Fragen, Kontext, Code, Bilder), geht direkt an OpenAI und Google, unter Ihren Konten und deren Bedingungen – von Ihrem Computer aus oder, in Cloud-Sitzungen von Claude Code, aus Ihrer eigenen Cloud-Umgebung über den Netzwerk-Proxy von Anthropic für diese Umgebung. Kirat hat keinen Server, kein Konto bei uns und keine Telemetrie. Wir sehen weder Ihre Keys noch Ihre Daten.
Auf Ihrem Computer legt Kirat einen Ordner .kirat in Ihrem Home-Verzeichnis an: der tägliche Kostenzähler, das Kostenprotokoll, die letzten 20 Ergebnisse (sie enthalten Ihre Fragen und Antworten), das Protokoll delegierter Entscheidungen und erzeugte Bilder. Sie können ihn jederzeit löschen.
Wenn Ihre Daten nicht an OpenAI oder Google gehen dürfen, ist Kirat nichts für Sie.
Die Details, zum Nachlesen.
Alles Weitere vollständig: was Kirat nicht kann und weitere Fragen. Öffnen Sie, was Sie brauchen.
Was Kirat nicht leistet
- —Es ist nicht deterministisch. LLM-Ausgaben variieren zwischen Läufen. Was sich hier wiederholt, ist das Verfahren – dasselbe Werkzeug, dieselben Modelle, dasselbe Rundenlimit, dieselben Ergebnisfelder –, nicht der Text, den die Modelle erzeugen.
- —Übereinstimmung ist keine Validität. Übereinstimmung zwischen Modellfamilien ist ein deskriptives Signal innerhalb der Modelle, die Sie zufällig gewählt haben. Verschiedene Modellfamilien irren auf verschiedene Weise, aber sie können sich dennoch auf eine falsche Antwort einigen.
- —Konfidenzwerte sind selbst angegeben. Die Modelle nennen eine Zahl. Sie ist nicht kalibriert, sie ist keine Wahrscheinlichkeit und sollte auch nicht als solche ausgewertet werden.
- —Es ist kein validiertes Instrument. Dahinter steht kein Paper, keine Validierungsstudie, kein Peer-Review. Es ist ein dokumentiertes Verfahren und ein Ergebnisformat. Was Sie daraus schließen, verantworten Sie.
- —Der Rat besteht nicht immer aus denselben drei Mitgliedern. Nach wiederholten API-Fehlern pausiert der Circuit Breaker ein Mitglied für den Rest der Sitzung. Ein Aufruf, der bei maximalem Aufwand in eine Zeitüberschreitung läuft, wird einmal wiederholt, eine Aufwandsstufe niedriger. Mit nur einem API-Key hat der Rat ein externes Mitglied, und jedes Ergebnis nennt den fehlenden Key.
kirat_statuszeigt, welche Mitglieder verfügbar sind – prüfen Sie das vor einer Serie von Läufen. - —Es ist kein Datenspeicher. Kirat behält nur die letzten 20 Ergebnisse, im Ordner
.kiratin Ihrem Home-Verzeichnis. Speichern Sie jedes Ergebnis, das Sie auswerten möchten, selbst. - —Es läuft nicht überall, wo Sie Claude nutzen. Nur dort, wo Claude Werkzeuge auf einem Rechner ausführt, auf dem Kirat installiert ist: Chats in Claude Desktop unter macOS und Windows, Claude Code im Terminal oder in VS Code, lokale Sitzungen im Code-Tab von Claude Desktop, SSH-Sitzungen – und Cloud-Sitzungen von Claude Code (Cloud-Sitzungen im Code-Tab, Claude Code im Web oder in der Mobil-App) nach einer einmaligen Einrichtung Ihrer Cloud-Umgebung. Die Cloud hat Grenzen: Alle, die die Umgebung nutzen, können ihre Umgebungsvariablen lesen, einschließlich Ihrer Keys; Kirats Tagesbudget zählt pro Sitzung, legen Sie also Ausgabenlimits bei OpenAI und Google fest; Hintergrundaufträge und die letzten Ergebnisse enden mit der Sitzung; und die Umgebung muss zwei Hosts zulassen,
api.openai.comund den Download-Host von Kirat. Schlägt die Einrichtung fehl, startet die Sitzung trotzdem, nur ohne Kirat, und der fehlgeschlagene Zustand kann für neue Sitzungen zwischengespeichert bleiben, bis Sie das Setup-Skript bearbeiten. Nicht der Chat im Browser oder in den Mobil-Apps und nicht Cowork-Aufgaben, die in der Cloud laufen. WSL-Sitzungen und lokale Cowork-Aufgaben sind nicht getestet. Netzwerke auf Ihrem eigenen Computer, die einen HTTP-Proxy erfordern, werden nicht unterstützt – das sollten Sie in einem Netzwerk Ihrer Einrichtung prüfen. Organisationen, die Desktop-Erweiterungen auf eine Allowlist beschränken, blockieren manuelle Installationen; fragen Sie Ihre Administration. Wo es läuft, vollständig.
Weitere Fragen
Was kostet ein Lauf, und wie lange dauert er?
Eine Entscheidung des Rats kostet in unseren gemessenen Läufen $0.02 bis $0.15, je nach Aufwandsstufe und Eingabegröße, und dauert 8 Sekunden bis 3 Minuten. Sie bezahlen OpenAI und Google direkt. Drei Modelle kosten mehr als eines.
Lange Läufe geben sofort ein Ticket zurück und laufen im Hintergrund zu Ende; Claude holt das Ergebnis mit kirat_result ab, sodass eine Zeitüberschreitung im Client kein bereits bezahltes Ergebnis verschluckt. Zeitlimits werden pro Anbieter festgelegt, abgeleitet aus dem gemessenen Durchsatz, weil sich die Anbieter unterscheiden: Der mittlere Ausgabedurchsatz (Median) lag bei gpt-5.6 ≈ 48 Tokens/s und gemini-3.6-flash ≈ 196 Tokens/s (Produktivläufe, Aug. 2026, ein einzelner Container in der EU).
Ein Budgetwächter reserviert vor jedem Aufruf die Kosten für den ungünstigsten Fall und blockiert Aufrufe, die das Tagesbudget überschreiten könnten – standardmäßig $5 pro UTC-Tag, anpassbar. Er arbeitet nach bestem Bemühen, legen Sie also auch bei den Anbietern Ausgabenlimits fest. Ein separates Projekt beim Anbieter mit eigenem Limit ist eine gute Idee.
Lizenz für die Nutzung in der Forschung?
Kirat wird unter einer proprietären Lizenz verkauft, nicht unter einer Open-Source-Lizenz. Eine Lizenz gilt für eine Person, auf beliebig vielen eigenen Geräten und eigenen Cloud-Umgebungen dieser Person. Eine Weitergabe ist nicht erlaubt, daher braucht jedes Mitglied Ihrer Gruppe, das Kirat nutzt, eine eigene Lizenz, und eine mit anderen geteilte Cloud-Umgebung braucht eine Lizenz pro Person.
Sie dürfen die Ergebnisse in Ihrer eigenen Arbeit verwenden, kommerzielle Arbeit eingeschlossen.